- Leistungen
- SEO und KI-Sichtbarkeit
- Webdesign
- Marketingberatung
- Social Media
- Onepage.io Support
- Einsatzgebiete
- SEO Frankfurt
- SEO Mainz
- SEO Wiesbaden
- Webdesign Frankfurt
- Webdesign Mainz
- Webdesign Wiesbaden
- KI-Optimierung Frankfurt
- KI-Optimierung Mainz
- KI-Optimierung Wiesbaden
- KI und AIO
- SEO, GEO und AIO erklärt
- EU-AI-Act-Schulung
- Wissen und Hilfe
- Online-Marketing-Lexikon
- Schulungen
- Support
- Über uns
- Blog
- Kontakt
Blog · KI-Sichtbarkeit
KI-Crawler auf die Website lassen oder aussperren?
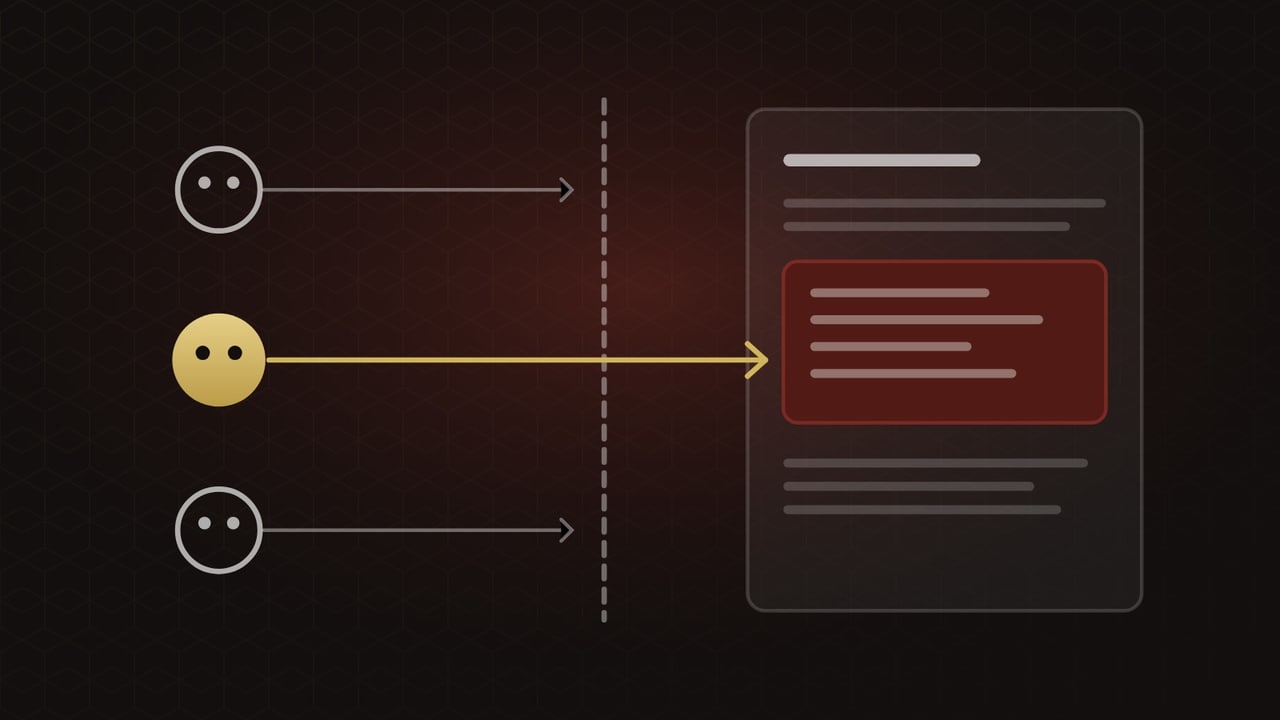
Ein KI-Crawler ist ein Programm, das Webseiten für KI-Dienste abruft. Manche sammeln Trainingsdaten, andere holen Seiten für Suchantworten. Wer beides trennt, kann das Training sperren und in KI-Suchen sichtbar bleiben.
Antwort zuerst
Das Wichtigste auf einen Blick
Fünf Sätze für alle, die wenig Zeit haben.
OpenAI und Anthropic trennen ihre Crawler nach Aufgaben: Einer sammelt Trainingsdaten, ein anderer holt Seiten für Suchantworten.
Bei OpenAI heißen sie GPTBot und OAI-SearchBot, bei Anthropic ClaudeBot und Claude-SearchBot. So beschreiben es beide auf ihren eigenen Hilfeseiten.
Wer den OAI-SearchBot sperrt, erscheint laut OpenAI nicht mehr in den Suchantworten von ChatGPT.
Eine Änderung an der robots.txt greift laut OpenAI nach etwa 24 Stunden. Die Sperre von GPTBot betrifft dagegen nur das Training.
Google-Extended steuert laut Google das Training künftiger Gemini-Modelle, aber nicht die KI-Übersichten in der Google-Suche.
Für AI Overviews und AI Mode gelten laut Google die Regeln für den Googlebot. Seit dem 31.08.2026 gibt es dafür zusätzlich einen Schalter in der Search Console.
Nicht jeder KI-Abruf richtet sich nach der robots.txt: ChatGPT-User und Perplexity-User rufen Seiten im Auftrag von Nutzern ab.
Laut OpenAI gilt die robots.txt für ChatGPT-User womöglich nicht. Perplexity schreibt, dass Perplexity-User sie im Allgemeinen ignoriert.
Eine llms.txt braucht Ihre Website für die KI-Funktionen der Google-Suche nicht.
Google schreibt, dass dafür keine neuen maschinenlesbaren Dateien oder KI-Textdateien nötig sind. Dass KI-Suchdienste die Datei auf Ihrer Website auswerten, ist nicht belegt.
So arbeiten die Crawler
Training und Suche sind zwei verschiedene Türen
Die robots.txt ist eine Textdatei im Hauptverzeichnis Ihrer Website. Darin steht, welcher Crawler welche Bereiche abrufen darf. Bei KI-Diensten kommt es darauf an, welchen Crawler Sie ansprechen.
In Erstgesprächen höre ich oft den Satz: Wir sperren die KI aus. Gemeint ist meist etwas anderes. Die Texte sollen nicht in ein Trainingsmodell wandern. In ChatGPT genannt werden wollen die Betriebe trotzdem.
Genau diese Trennung bieten mehrere Anbieter an. OpenAI schickt GPTBot für das Training und OAI-SearchBot für die Suche. Bei Anthropic heißen die beiden ClaudeBot und Claude-SearchBot. Den PerplexityBot nutzt Perplexity laut eigener Aussage nicht für das Training.
Bei Google und Apple läuft es anders. Google-Extended ist kein eigener Crawler, sondern ein Steuerzeichen in der robots.txt. Es regelt laut Google das Training künftiger Gemini-Modelle und das Grounding in Gemini Apps. Grounding heißt, dass Antworten auf Webinhalte gestützt werden. Auf die Google-Suche hat Google-Extended laut Google keinen Einfluss. Ähnlich bei Apple: Seiten, die Applebot-Extended sperren, erscheinen laut Apple weiter in Spotlight, Siri und Safari.
Für Copilot beschreibt Microsoft keinen eigenen KI-Crawler. Copilot schickt Suchanfragen an Bing. Gesteuert wird über Meta-Tags im Seitenkopf. Mit NOARCHIVE nutzt Bing eine Seite laut Microsoft weder für den Chat noch für das Training. In der Bing-Suche bleibt sie. Die Angabe stammt vom 22.09.2023, als Copilot noch Bing Chat hieß.
Viele Websites laufen über Cloudflare, einen Netzwerkdienst zwischen Server und Besucher. Cloudflare hat für neue Domains mit Werbung ab dem 15.09.2026 eine Standardsperre für Training und Agenten angekündigt. Wer dort Training blockiert, sperrt laut Cloudflare auch Mehrzweck-Crawler wie Googlebot und Bingbot aus. Das kann Ihre normale Sichtbarkeit kosten.
In vier Schritten zur passenden robots.txt
Ziel festlegen
Entscheiden Sie zuerst: in KI-Suchen auftauchen, Training verhindern oder beides. Ohne diese Entscheidung ist jede Zeile geraten.
Bestand prüfen
Rufen Sie ihredomain.de/robots.txt im Browser auf. Prüfen Sie, welche Crawler dort schon stehen, vor allem Googlebot und Bingbot.
Sicherung anlegen
Speichern Sie die bisherige Datei. Übernehmen Sie dann die passenden Zeilen aus der Entscheidungshilfe.
Nach einem Tag gegenprüfen
OpenAI nennt etwa 24 Stunden, bis eine Änderung greift. Rufen Sie die Datei danach erneut auf.
Zum Anfassen
Welche robots.txt-Zeilen passen zu Ihrem Ziel?
Wählen Sie Ihr Ziel. Darunter stehen die passenden Zeilen mit Erklärung. Aufgeführt sind nur Crawler, die die Anbieter selbst dokumentieren.
Die Such-Crawler sind ausdrücklich zugelassen. Die Trainings-Crawler bleiben ungesperrt.
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Was jede Zeile bewirkt
User-agent: GoogleboterlaubtHolt Seiten für die Google-Suche. Seine Regeln gelten laut Google auch für AI Overviews und AI Mode.
User-agent: BingboterlaubtCrawler von Bing. Copilot schickt laut Microsoft seine Suchanfragen dorthin.
User-agent: OAI-SearchBoterlaubtHolt laut OpenAI Seiten für die ChatGPT-Suche. Ist er gesperrt, erscheinen Sie dort nicht mehr.
User-agent: Claude-SearchBoterlaubtVerbessert laut Anthropic die Suchergebnisse von Claude. Eine Sperre kann die Sichtbarkeit dort mindern.
User-agent: PerplexityBoterlaubtZeigt laut Perplexity Websites in den Suchergebnissen an. Fürs Training dient er nicht.
Aus der Praxis
Was Sie je nach Ausgangslage tun
Ich verspreche niemandem, dass eine robots.txt ihn in ChatGPT bringt. Das kann keiner seriös. Die Datei öffnet oder schließt nur Türen. Was dahinter passiert, entscheiden die Anbieter.
Nehmen wir einen Malerbetrieb in Hochheim. Er will kein Training, aber als Quelle auftauchen. Für ihn passt die mittlere Variante der Entscheidungshilfe.
| Ausgangslage | Was Sie tun | Warum |
|---|---|---|
| Sie wollen in ChatGPT, Claude und Perplexity als Quelle auftauchen | OAI-SearchBot, Claude-SearchBot und PerplexityBot nicht sperren. | Laut OpenAI verschwinden Sie mit einer Sperre aus den Suchantworten. Anthropic schreibt, dass die Sichtbarkeit sinken kann. |
| Sie wollen in Googles KI-Übersichten auftauchen | Googlebot offen lassen und den Schalter in der Search Console nicht abwählen. | Google-Extended wirkt dort laut Google nicht. |
| Sie wollen nicht in Googles KI-Übersichten erscheinen | Den Schalter in der Search Console nutzen. Er ist seit dem 31.08.2026 weltweit verfügbar. | Laut Google kommen dann keine Besuche und Impressionen mehr aus diesen Funktionen. Für die übrigen Ergebnisse ist der Schalter kein Ranking-Signal. |
| Sie wollen in Copilot sichtbar sein | Bingbot zulassen und kein NOARCHIVE im Seitenkopf setzen. | Mit NOARCHIVE nutzt Bing die Seite laut Microsoft nicht für den Chat. |
| Ihre Website läuft über Cloudflare | Die Bot-Einstellungen im Bereich Security prüfen. | Eine Trainingssperre kann laut Cloudflare auch Googlebot und Bingbot treffen. |
Mir ist wichtig, dass Sie diese Entscheidung bewusst treffen und regelmäßig prüfen. Den Schalter in der Search Console gibt es zum Beispiel erst seit dem 31.08.2026.
Häufige Fragen
Vier Fragen zu KI-Crawlern
Kurze Antworten mit Quelle, ohne Umweg.
Nein. Google schreibt, dass Google-Extended keinen Einfluss auf die Aufnahme in die Google-Suche hat und kein Ranking-Signal ist. Das Steuerzeichen regelt das Training künftiger Gemini-Modelle, das Grounding in Gemini Apps und Grounding with Google Search auf Vertex AI. Die KI-Übersichten in der Google-Suche erreichen Sie damit allerdings nicht. Dafür gelten laut Google die Regeln für den Googlebot und seit dem 31.08.2026 ein Schalter in der Search Console.
OpenAI nennt für den OAI-SearchBot etwa 24 Stunden. Wer auch die Links auf seine Seiten in ChatGPT unterdrücken will, braucht laut OpenAI zusätzlich ein noindex. Das ist eine Anweisung im Seitenkopf, die Seite nicht aufzunehmen. Damit der Crawler diese Anweisung lesen kann, darf die Seite in der robots.txt nicht gesperrt sein. Eine Sperre in der robots.txt und ein noindex auf derselben Seite vertragen sich deshalb nicht. Besuche aus ChatGPT erkennen Sie am Zusatz utm_source=chatgpt.com in Ihrer Webanalyse.
Nicht alle. Anthropic schreibt, dass seine Bots die robots.txt beachten und eine Crawl-Verzögerung unterstützen. Perplexity sagt das für den PerplexityBot. Anders ist es bei Abrufen, die Nutzer mit ihren Fragen oder Aktionen auslösen. Laut OpenAI gilt die robots.txt für ChatGPT-User womöglich nicht. Perplexity schreibt, dass Perplexity-User sie im Allgemeinen ignoriert. Die robots.txt ist also eine Regel für Crawler, aber kein Schloss.
Für Google nicht. Google schreibt, dass Sie für die KI-Funktionen der Suche keine neuen maschinenlesbaren Dateien, KI-Textdateien oder besonderes Markup brauchen. Die llms.txt hat Jeremy Howard am 03.09.2024 vorgeschlagen. Laut Projektseite veröffentlichen OpenAI, Anthropic und Gemini eine solche Datei für ihre eigene Entwickler-Doku. Dass ihre Crawler die Datei auf anderen Websites auswerten, steht dort nicht. Ich stecke die Zeit deshalb lieber in klare Seiten und eine saubere robots.txt.
Über den Autor

Kevin Schäfer
- Geschäftsführer
- Online-Marketing Consultant
- Freier Sachverständiger für SEO und Webdesign
Kevin Schäfer ist seit 2010 im Marketing tätig und hat Schäfer Online-Marketing am 1. Mai 2020 gegründet. Über 90 Betriebe sind bei Schäfer Online-Marketing in laufender Betreuung. Als freier Sachverständiger für SEO und Webdesign stützt er technische Ratschläge auf die Angaben der Anbieter.
Schäfer Online-Marketing · Beratungsbüro Darmstädter Straße 11 · 65474 Bischofsheim · Telefon 06146 90 96 072
Nächster Schritt
Klären wir, welche Crawler bei Ihnen offen sind
Wenn Sie unsicher sind, was in Ihrer robots.txt steht, sehen wir gemeinsam nach. Eine Nennung in KI-Antworten sage ich dabei nicht zu. Das kann keiner seriös.
Lieber direkt sprechen? Telefon 06146 90 96 072 oder anfrage@schaefer-online-marketing.de
Verwendete Quellen
- OpenAI, Overview of OpenAI Crawlers, abgerufen 17.09.2026
- OpenAI Help Center, Publishers and Developers FAQ, abgerufen 17.09.2026
- Anthropic, Claude Help Center, Does Anthropic crawl data from the web and how can site owners block the crawler, aktualisiert am 07.04.2026
- Perplexity, Perplexity Crawlers, abgerufen 17.09.2026
- Google Search Central, Google's common crawlers, abgerufen 17.09.2026
- Google Search Central, AI features and your website, Stand 10.12.2025
- Google Blog, Mrinalini Loew, neue Steuerung für Website-Betreiber, veröffentlicht am 03.06.2026, aktualisiert am 31.08.2026
- Apple Support, Artikel 119829 zu Applebot, aktualisiert am 04.09.2026
- Common Crawl, CCBot, abgerufen 17.09.2026
- Microsoft Support, How web search works in Microsoft 365 Copilot Chat, abgerufen 17.09.2026
- Bing Webmaster Blog, Fabrice Canel, Announcing new options for webmasters to control usage of their content in Bing Chat, 22.09.2023
- Jeremy Howard, The llms.txt file, Vorschlag vom 03.09.2024
- Cloudflare Blog, Tomé, Abrufe und Verweise von KI-Crawlern, 29.08.2025
- Cloudflare Blog, Ankündigung zu KI-Optionen vom 01.07.2026
Die Aussagen zu den Crawlern stammen von den Anbietern selbst. Die Cloudflare-Werte sind Anbietermessungen mit nur teilweise veröffentlichten Rohdaten. Ob die Änderung zum 15.09.2026 umgesetzt wurde, ist nicht geprüft. Alle Quellen wurden am 17.09.2026 geprüft.
© 2026 Schäfer Online-Marketing, Kevin Schäfer. USt-IdNr. DE330104626